B 版领先了。有人截了张图发到群里。设计师很高兴,商家想马上铺开,下一季的简报已经按这个新思路在写了。
可是实验还在跑。
最容易犯的错,是把一个早期排名变成一条业务准则:特写胜过场景图,短标题胜过长标题,理性文案胜过感性文案。一次结果很少撑得起这么宽的结论。一次没跑完的结果,能撑起的就更少。
有用的问题要窄得多:在这次测试的条件下,这处改动有没有帮到客户挑选这件商品?
Amazon 的 Manage Your Experiments 会把详情页访客随机分配到不同的内容版本。使用它需要专业卖家账号、相应的品牌代表权限和已备案的品牌;具体商品还需要近期有足够的流量。在团队围绕这个工具排测试日程之前,应该先去卖家平台确认资质。
先写下那个决定,再去设计挑战者。
设想一件用来举例的铁锈红狗用胸背带:两处调节点,侧面一个卡扣。它现在的 A+ 内容从一张户外场景图开头。拟议的替代版本,则从「这条背带怎么穿上去」的清楚说明开头。
「做得更高级一点」是一个很弱的假设。它让几乎任何一个好看的设计都能算作成功。
一个有用的假设应该是这样:「把穿戴顺序放在开头,会让这条背带更容易被评估,从而在我们选定的购买指标上优于现在的开场。」
这样一来,团队知道 B 版为什么存在,也知道哪种解读会过宽。即便 B 赢了,这个结果也不能确立「场景图在整个商品库里都没用」。
让差异足够有意义,让推论足够诚实。
保持商品参数完全一致且准确。让两种做法在视觉上差异明显到足以检验那个假设。只改一个很小的点缀色,却指望得到一个决定性的商业结论,多半只会消耗流量,学不到什么。
当你要测试的是一整套连贯的新呈现时,是可以同时改动多个页面元素的。Amazon 支持多属性实验。这种情况下,请把结果描述成「关于这一整套处理的证据」。当标题、图片和五点描述一起变了,你没法把功劳单独记在标题头上。
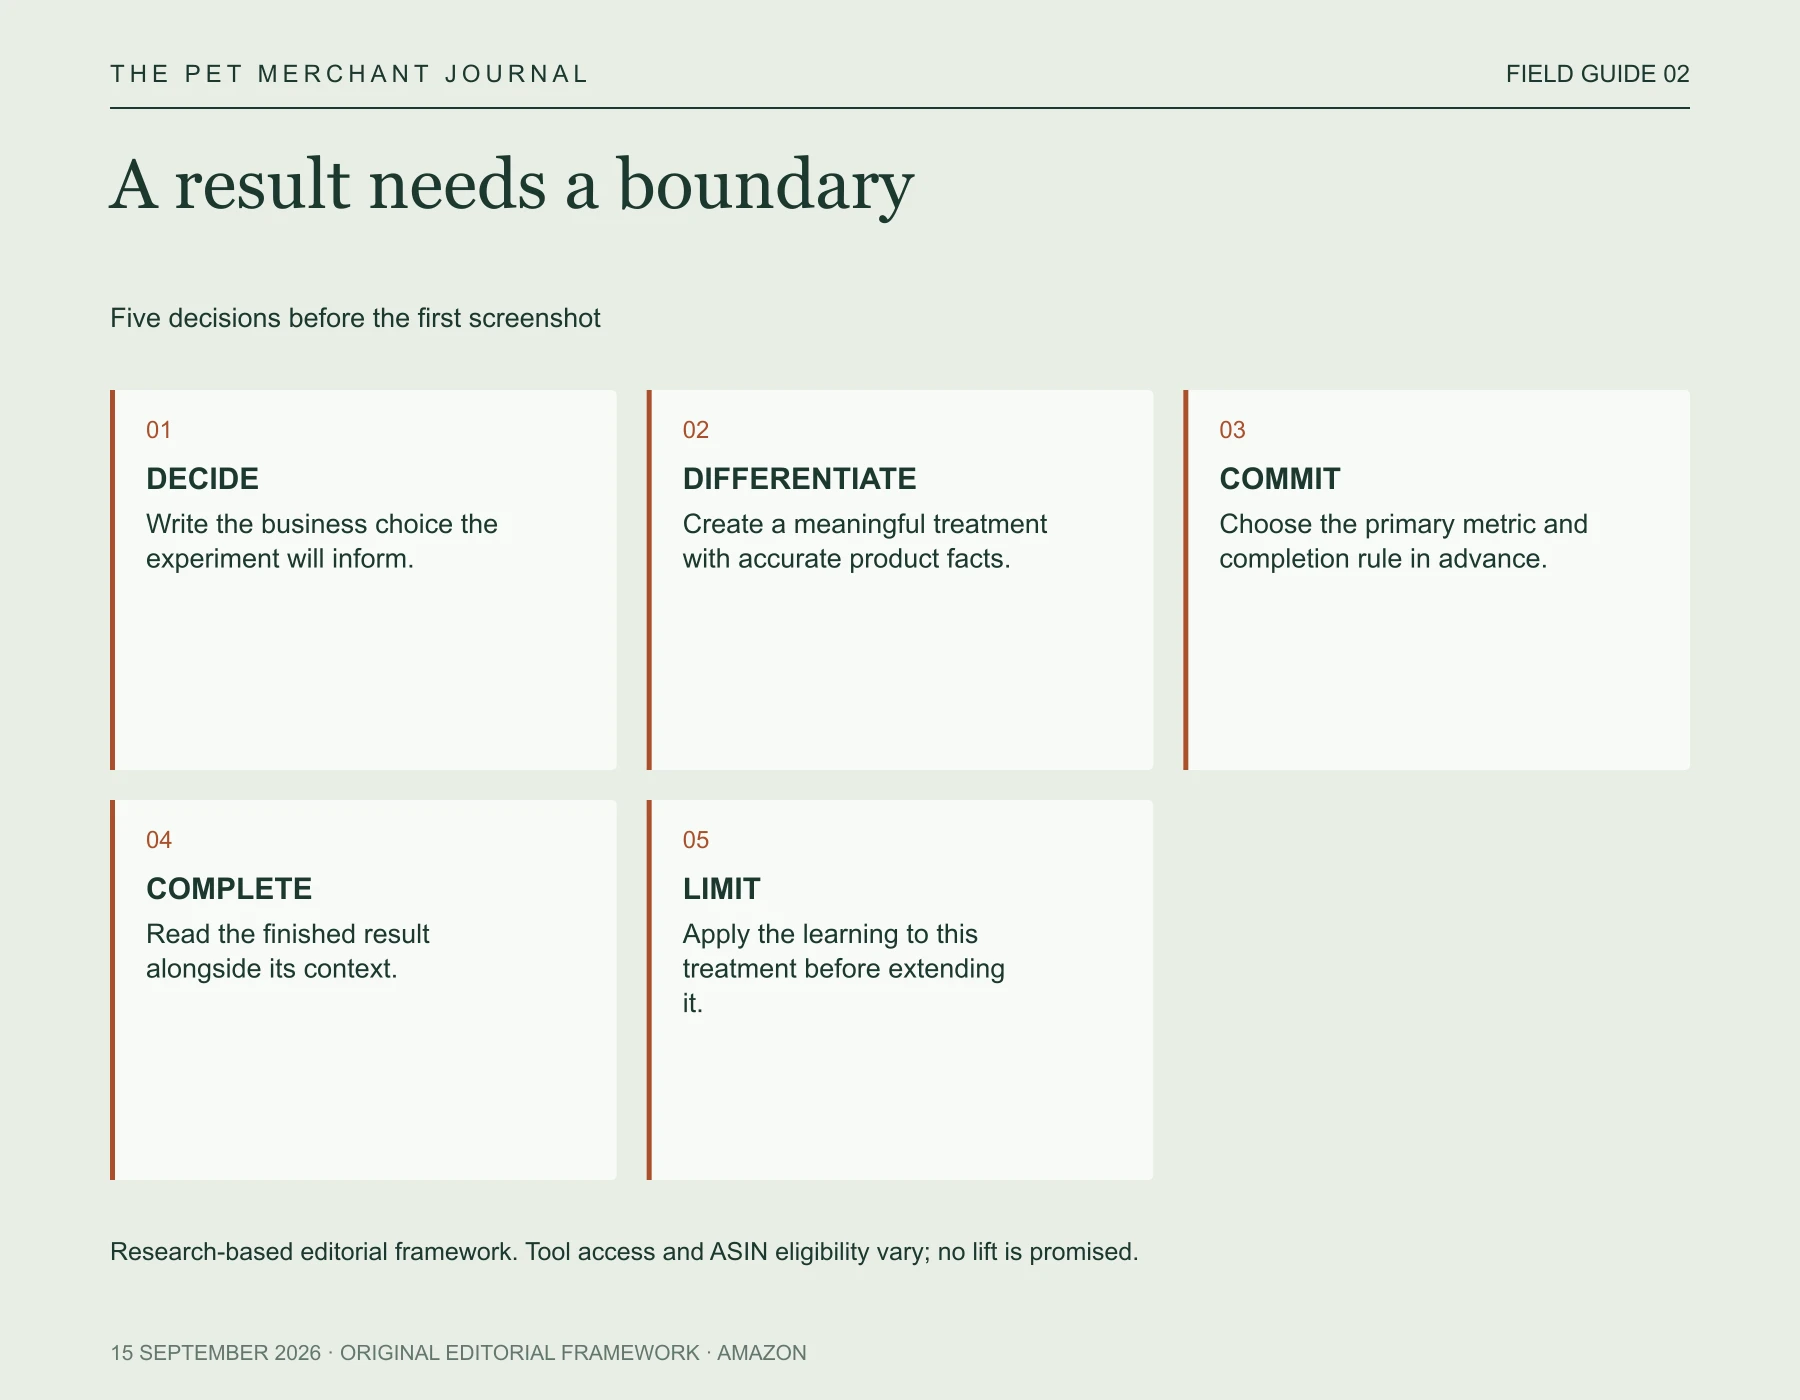
原创编辑框架。基于调研的编辑框架。工具权限与 ASIN 资质因人而异;本文不承诺任何提升。
下面是一份宠物商家可以重复使用的精简实验简报:
| 字段 | 胸背带示例 |
|---|---|
| 决定 | 保留现在的开场,还是改用穿戴说明 |
| 假设 | 更清楚的穿戴信息,会改善选定的购买指标 |
| 处理 | 替换 A+ 开头的说明;已核实的商品参数保持一致 |
| 主指标 | 上线前先选定一个可用的购买指标 |
| 结束规则 | 采用平台选定的时长或结束设置 |
| 解读边界 | 仅限这个 SKU 和这套处理;不自动推广到整个商品库 |
让实验跑完,再读完整的结果。
等到选定的结束节点,哪怕早期结果看着很有希望。Amazon 的流程里有一个「跑到显著」的时长选项和一个自动发布设置;上线前请认真看一遍这些设置。结果页会给出多项指标,以及某个版本更优的概率。
提前定好主决策指标,这样团队事后就不能挑一个最好看的数字来用。其余指标用来看上下文,包括样本量。一个更高的订单数,如果脱离「有多少访客看到过」来看,很容易引出错误的比较。
不要给每家店凭空发明一个通用的置信阈值或样本量。用平台给出的完整结果,并弄清楚它报告的到底是什么。对未来销售的预测是一个规划估算,不是已经入账的收入。
把测试期间发生的事记下来。
简单记录库存情况、价格变动、促销活动和异常事件。随机同期测试,和「这个月换内容、拿去和上个月比」是两回事。后者同时也换掉了时间段,还可能换掉了来的人。
在判断一个结果该不该指导下一季、或者另一件商品时,上下文依然重要。一段在促销期间测出来的背带说明,值得的可能是一次更小范围的推广,而不是一条新的长期设计标准。
当证据无法得出结论时,把这个结果也记下来。你仍然可以偏好其中一个版本——因为它把商品讲得更清楚,或者维护成本更低。那就把它称作一个编辑决定或运营决定,不要为它编造一个测出来的提升。
低流量商品尤其需要耐心。如果某个 ASIN 不符合资质,访谈和理解度检查可以暴露误解,但它们替代不了一次随机化的销售实验。
最有价值的产出,往往是一个更锋利的下一个问题。如果穿戴信息在这条背带上赢了,那么更清楚的穿戴说明,会不会也帮到另一件结构复杂的商品?那就是一个新的假设,可以拿去做下一次测试。
截图留着。等结果出来。然后把「它到底允许你相信什么」原原本本写下来。